Diagnóstico por algoritmo: o desempenho real só aparece depois da implantação
Por Nadelson Costa Nogueira Júnior ·
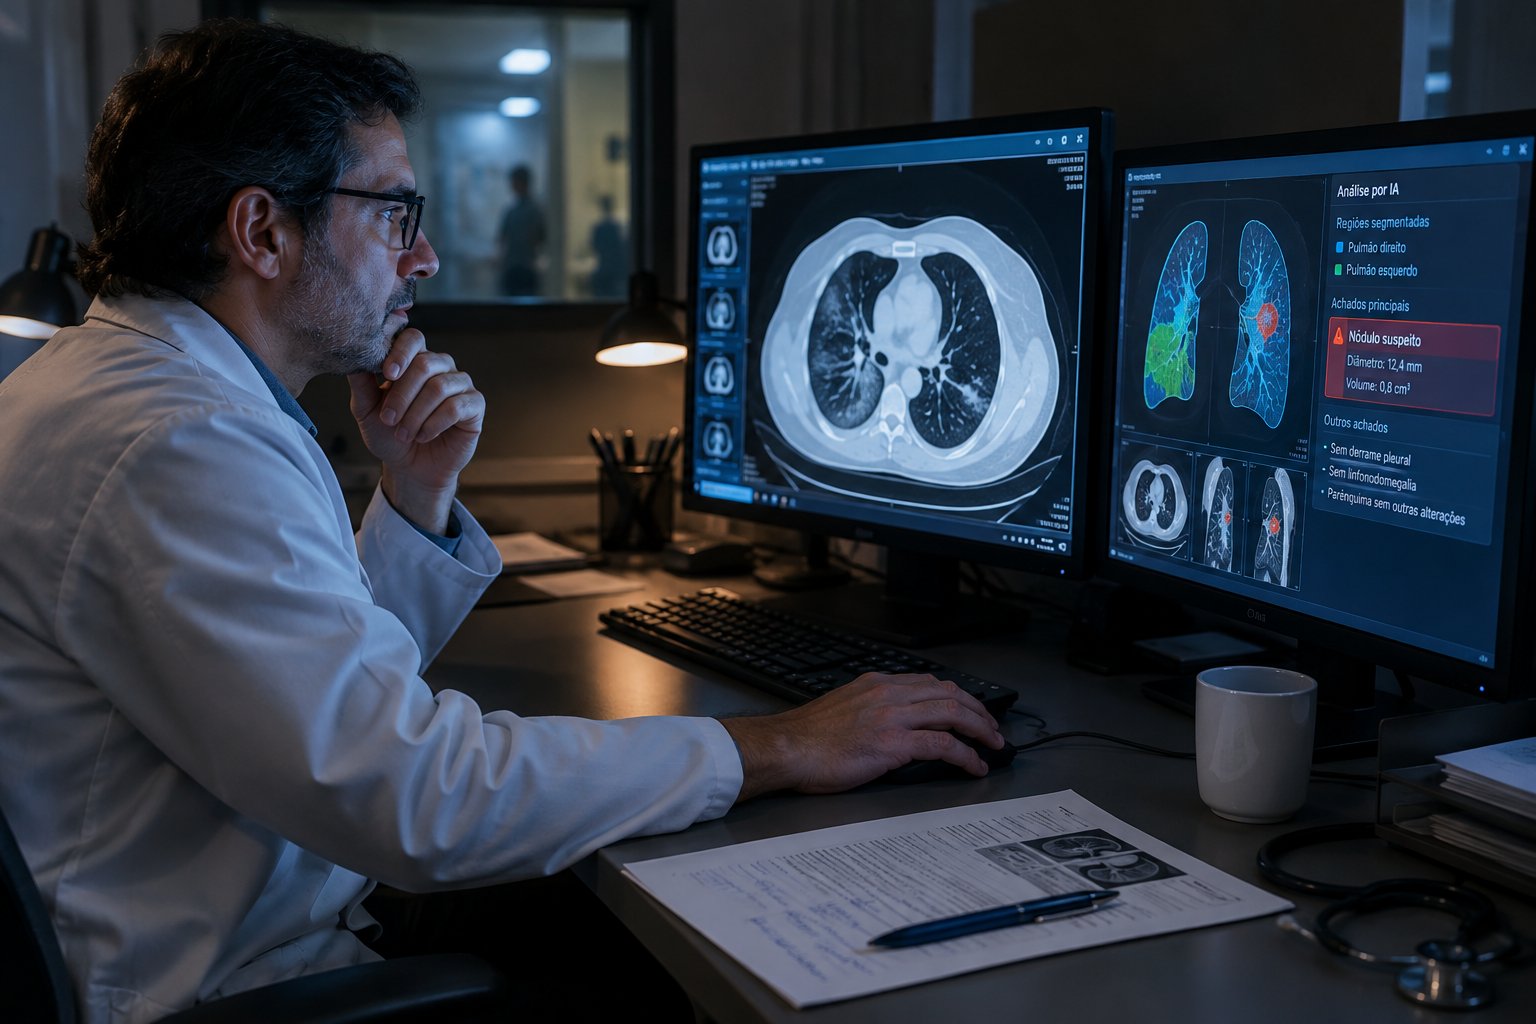
Em 26 de agosto de 2026, o uso de inteligência artificial na medicina brasileira deixou de ser terreno de boa prática e passou a ser objeto de norma. A Resolução CFM nº 2.454/2026 entrou em vigor naquele dia, após 180 dias de prazo para adequação, e alcançou inclusive os sistemas já em operação. O marco importa por um motivo específico: ele resolve, no plano ético-profissional, uma pergunta que o setor vinha postergando — quem responde quando o algoritmo erra.
A resposta normativa é direta. A IA é ferramenta de apoio; o médico permanece responsável final pelas decisões clínicas, diagnósticas, terapêuticas e prognósticas. Mas a norma não se limita a atribuir dever. Ela cria contrapartidas: o direito de recusar sistemas sem validação científica adequada ou certificação regulatória pertinente, o dever de registrar em prontuário o uso da ferramenta e o direito à proteção contra responsabilização indevida por falhas atribuíveis exclusivamente ao sistema, desde que comprovado uso diligente, crítico e ético.
Esse último item é o que altera a operação. Ao condicionar a proteção ao registro e ao julgamento documentado, a resolução transforma o prontuário em instrumento de defesa e cria incentivo concreto para governança — não apenas para conformidade formal.
O que a aprovação regulatória não garante
Enquanto a norma brasileira organizava o campo ético, o volume de dispositivos autorizados seguia curva própria. O centro de dispositivos médicos do FDA ultrapassou 1.300 dispositivos com IA autorizados para comercialização, com 149 designações de tecnologia breakthrough em 2025 e 124 novos dispositivos aprovados no mesmo ano.
O número impressiona, mas mede apenas uma coisa: capacidade de demonstrar segurança e desempenho em condições controladas. Não mede o que acontece quando o sistema encontra o hospital.
O caso mais didático é o de um modelo proprietário de predição de sepse implantado em centenas de hospitais norte-americanos. Validação externa publicada em 2021 encontrou AUC de 0,63 no mundo real, contra 0,76 a 0,83 reportados pelo desenvolvedor. O sistema deixou de identificar 67% dos pacientes com sepse e gerava alertas em 18% de todos os internados. No limiar recomendado pelo próprio fabricante, identificava apenas 7% dos casos que o clínico havia perdido.
Nenhuma dessas falhas nasceu de erro de programação. Todas vieram de três decisões institucionais: validar internamente, escalar antes da validação independente e tratar desempenho reportado como desempenho verificado.
O viés mora na variável, não no dado
A explicação mais difundida para comportamento discriminatório em modelos clínicos aponta para falta de diversidade nas bases de treinamento. É parte do problema — e é a parte mais fácil de resolver.
Em 2019, um estudo na Science demonstrou uma forma mais sutil: um algoritmo usado para encaminhar pacientes a programas de cuidado intensivo previa custo de saúde em vez de doença. Como o acesso ao cuidado é desigual, o modelo aprendia que pacientes negros demandavam menos recurso e os classificava como menos graves. Corrigir a variável-alvo elevaria de 17,7% para 46,5% a proporção de pacientes negros encaminhados ao programa.
A lição é de desenho, não de coleta. Antes de perguntar se a amostra é diversa, é preciso perguntar o que o modelo tenta prever — e se essa proxy representa de fato o fenômeno clínico relevante.
O segundo vetor de viés é ambiental. Um sistema de aprendizado profundo para rastreamento de retinopatia diabética, submetido a estudo prospectivo em programa nacional de triagem na Tailândia, tinha AUC de 0,79 na validação interna e 0,70 na externa. O modelo não mudou; mudaram o equipamento de captura, o protocolo de imagem e a população atendida. Em trabalho anterior do mesmo grupo, a combinação do sistema com fatores de risco clínicos disponíveis elevou a AUC externa de 0,62 para 0,71 — sinal de que o algoritmo gera valor quando integrado a um processo, não quando consultado isoladamente.
O risco que o humano na sala não elimina
A arquitetura de governança mais adotada hoje é o humano no circuito: o sistema sugere, o profissional decide. O desenho parece robusto. A evidência mostra que é mais frágil do que aparenta.
Em abril de 2026, um ensaio clínico randomizado publicado na NEJM AI testou exatamente essa premissa. Participaram 44 médicos e 264 casos diagnósticos. Todos haviam concluído 20 horas de formação em letramento em IA antes do experimento. Metade recebeu sugestões de um modelo de linguagem sem erros; a outra metade, sugestões com erros deliberados em metade das vinhetas.
Acurácia diagnóstica: 84,9% no grupo com recomendações corretas e 73,3% no grupo exposto a recomendações falhas — redução ajustada de 14 pontos percentuais. Na acurácia de primeira escolha, 90,5% contra 76,1%, diferença de 18,3 pontos.
O dado que importa não é a queda. É que ela ocorreu depois do treinamento. Vinte horas de formação não protegeram profissionais contra uma sugestão errada apresentada com aparência de autoridade. Políticas que tratam capacitação como solução suficiente estão construídas sobre uma hipótese já testada e refutada.
Há um segundo achado na mesma direção. Ensaio publicado no JAMA Network Open em outubro de 2024 mostrou que a disponibilidade de um modelo de linguagem como apoio diagnóstico não melhorou significativamente o raciocínio clínico em comparação com recursos convencionais — e o modelo, sozinho, superou os médicos que tinham acesso a ele. A ferramenta estava à mão e não foi usada de modo a produzir ganho. É o oposto do copiloto imaginado: um copiloto que o piloto não sabe consultar.
O paradoxo da explicabilidade
Existe uma intuição consolidada de que tornar o modelo explicável melhora a segurança. Ela é razoável e, isoladamente, falsa.
Revisão publicada em 2025 na AI & Society sobre viés de automação na colaboração humano-IA compilou os experimentos disponíveis e encontrou um padrão consistente: as explicações aumentaram a confiança do profissional no sistema, sem melhorar a acurácia diagnóstica. Em alguns desenhos, protocolos em que a IA apresentava sua recomendação antes da avaliação humana elevaram a acurácia, mas ampliaram o efeito de ancoragem — a tendência de o julgamento se ajustar à sugestão recebida.
Explicar torna o modelo mais convincente; não o torna necessariamente mais confiável. É por isso que a orientação da Organização Mundial da Saúde para modelos multimodais em saúde, com mais de 40 recomendações, não se limita a exigir transparência: exige auditoria pós-comercialização obrigatória e avaliação de impacto por terceiros independentes em implantações de larga escala.
O comparativo internacional calibra a ambição. Apenas 14 de 36 países da OCDE exigem avaliação de risco antes da implantação de sistemas de IA no setor público, 12 mantêm comitês internos de revisão e 11 realizam auditoria após a implantação. Auditoria posterior não é padrão consolidado nem nos países mais avançados — o que a torna oportunidade, não rotina.
Onde o Brasil está na camada sanitária
Se a norma ético-profissional foi resolvida, a camada sanitária tem contornos próprios. Software como dispositivo médico é regulado pela Anvisa, com notificação e registro conforme a RDC nº 657/2022 e a RDC nº 665/2022. Levantamento publicado na Revista de Direito Sanitário da USP identificou aproximadamente 150 softwares regularizados pela agência.
O contraste com os mais de 1.300 dispositivos autorizados nos Estados Unidos não indica atraso puro — indica mercados com escalas e incentivos distintos. Mas sugere que o volume de tecnologia em uso clínico no Brasil pode ser menor do que o debate público supõe, e que a governança precisa ser dimensionada para o que de fato está implantado, não para o que se projeta.
Quatro mecanismos que a evidência sustenta
Validação externa antes da implantação. A distância entre 0,79 e 0,70 na Tailândia, e entre 0,83 e 0,63 na sepse, não é exceção metodológica. É o padrão. Validação conduzida pelo fornecedor, em ambiente de treinamento, não constitui evidência de desempenho.
Monitoramento de desempenho depois da implantação. Modelos degradam. População muda, protocolo muda, equipamento muda. Sem medição contínua, a instituição opera com uma estimativa de qualidade que envelhece em silêncio.
Desenho de fluxo que posicione o julgamento humano antes da sugestão. A ordem importa mais do que a explicação. Um sistema que entrega a hipótese antes da avaliação médica produz simultaneamente ganho de acurácia e risco de indução — e é preciso escolher deliberadamente qual desses efeitos se aceita correr.
Registro documental de cada decisão assistida. No Brasil, desde agosto de 2026, isso deixou de ser boa prática e passou a ser dever normativo. É também o único caminho de acesso à proteção contra responsabilização indevida que a mesma norma assegura.
O que ainda não se sabe
A meta-análise mais abrangente disponível, publicada em 2025 no JMIR Medical Informatics, reuniu 30 estudos, 19 modelos de linguagem e 4.762 casos clínicos. A acurácia diagnóstica variou de 25% a 97,8%; a de triagem, de 66,5% a 98%. A maioria dos estudos apresentou alto risco de viés.
Um intervalo dessa amplitude não descreve uma tecnologia. Descreve um campo em formação, com métodos heterogêneos e resultados não comparáveis. Qualquer afirmação categórica — de que a IA diagnóstica salva vidas em escala ou de que é experimental e insegura — extrapola o que a literatura sustenta.
O que está demonstrado é mais estreito e mais útil: a tecnologia é regulatoriamente aprovada, clinicamente promissora e empiricamente instável. Seu desempenho real só se conhece depois da implantação, e o risco associado não se controla dentro do modelo. Controla-se no processo, na auditoria e no registro.
O avanço que falta não é algorítmico. É institucional.
Referências
Conselho Federal de Medicina. Resolução CFM nº 2.454, de 11 de fevereiro de 2026 — normatiza o uso da inteligência artificial na medicina (2026). in.gov.br
Portal Médico / CFM. Regras sobre uso da IA na medicina entram em vigor nesta quarta-feira, 26 de agosto (2026). portal.cfm.org.br
Associação Médica Brasileira. Cartilha Saúde Digital — Resolução CFM nº 2.454/2026 (2026). amb.org.br
FDA / CDRH. CDRH Annual Report 2025 (2026). fda.gov
FDA. List of Artificial Intelligence-Enabled Medical Devices (2026). fda.gov
Wong, A. et al. External Validation of a Widely Implemented Proprietary Sepsis Prediction Model in Hospitalized Patients. JAMA Internal Medicine, 181(8):1065-1070 (2021). jamanetwork.com
Obermeyer, Z. et al. Dissecting racial bias in an algorithm used to manage the health of populations. Science, 366(6464):447-453 (2019). pubmed.ncbi.nlm.nih.gov
Ruamviboonsuk, P. et al. Real-time diabetic retinopathy screening by deep learning in a multisite national screening programme. Lancet Digital Health, 4(4):e235-e244 (2022). thelancet.com
Xie, Y. et al. Predicting the risk of developing diabetic retinopathy using deep learning. Lancet Digital Health (2021). thelancet.com
Automation Bias in Large Language Model–Assisted Diagnostic Reasoning among Physicians Trained in AI Literacy — A Randomized Clinical Trial. NEJM AI (2026). ai.nejm.org
Effect of a Large Language Model on Diagnostic Reasoning — A Randomized Clinical Trial. JAMA Network Open (2024). jamanetwork.com
Exploring automation bias in human–AI collaboration: a review and implications for explainable AI. AI & Society (2025). link.springer.com
Shan, G. et al. Comparing Diagnostic Accuracy of Clinical Professionals and Large Language Models: Systematic Review and Meta-Analysis. JMIR Medical Informatics, 13:e64963 (2025). pubmed.ncbi.nlm.nih.gov
Organização Mundial da Saúde. Ethics and governance of artificial intelligence for health: guidance on large multi-modal models (2024). who.int
OCDE. Digital Government Outlook 2026 — Adopting and governing AI in government (2026). oecd.org
Anvisa. Manual para regularização de equipamento médico e software como dispositivo médico (2026). gov.br
Jambor, D. G. Avaliação regulatória de software como dispositivo médico com foco na inclusão e equidade nas aplicações da inteligência artificial em saúde. Revista de Direito Sanitário, 25(1):e0017 (2025). revistas.usp.br
Nadelson Costa Nogueira Júnior